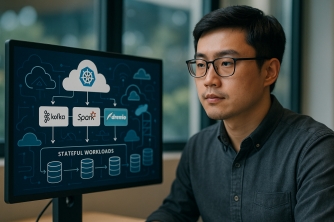
Với sự phát triển nhanh chóng của công nghệ, Kubernetes ngày càng trở thành một lựa chọn phổ biến cho việc triển khai Data Platform. Trong bài viết này, chúng ta sẽ tìm hiểu về cách tối ưu hóa các công cụ như Kafka, Spark và Dremio trên Kubernetes, cũng như kiến trúc tổng quát và những lưu ý khi quản lý tải công việc và lưu trữ.
Apache Spark là một công cụ mạnh mẽ trong xử lý dữ liệu lớn, mang lại hiệu quả và tốc độ vượt trội cho các ứng dụng về phân tích dữ liệu và trí tuệ nhân tạo. Bài viết này sẽ khám phá sâu hơn về vai trò của Spark trong Data Engineering, Data Warehouse, và Machine Learning, cùng những ứng dụng thực tế trong doanh nghiệp.