Tag "decode disaggregation".
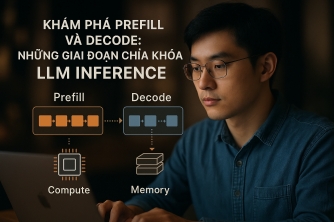
Trong thế giới của các mô hình ngôn ngữ lớn (LLM), hiểu rõ các giai đoạn Prefill và Decode là nền tảng để tối ưu hóa quá trình suy luận. Bài viết này sẽ đi sâu vào Prefill đối với Compute, Decode đối với Memory, và làm thế nào để tối ưu hóa hai giai đoạn này nhằm cải thiện hiệu năng LLM Inference.