
Trong kỷ nguyên số hóa hiện nay, bán dữ liệu cá nhân và ứng dụng trí tuệ nhân tạo (AI) đã trở thành vấn đề quan trọng và gây tranh cãi. Với sự phát triển của công nghệ, nguy cơ đánh cắp danh tính và lạm dụng dữ liệu nhạy cảm ngày càng gia tăng. Bài viết này sẽ phân tích sâu hơn về những thách thức và nguy cơ liên quan đến AI và an ninh dữ liệu.
Trong bối cảnh dữ liệu lớn ngày càng phát triển, việc lựa chọn công cụ phù hợp cho từng nhu cầu xử lý dữ liệu là rất quan trọng. Bài viết này sẽ giúp bạn khám phá ba công cụ mạnh mẽ: Apache Spark, Apache Hadoop, và Apache Flink. Chúng ta sẽ so sánh đặc điểm, lợi ích, và hạn chế của từng công cụ để cung cấp cái nhìn tổng quan và chuyên sâu.

Trong thập kỷ qua, công nghệ trí tuệ nhân tạo đã có những bước tiến ấn tượng, mở ra nhiều khái niệm và cải tiến đột phá, từ siêu trí tuệ AGI đến những tính năng tiên tiến trên smartphone do AI điều khiển. Bài viết này sẽ giới thiệu những thành tựu mới nhất và phân tích tương lai của công nghệ AI trong các ngành công nghiệp khác nhau.
Ngày nay, việc xử lý dữ liệu thời gian thực trở thành yếu tố sống còn của nhiều tổ chức. Spark Streaming và Structured Streaming được thiết kế đặc biệt để đáp ứng nhu cầu này. Qua bài viết này, chúng ta sẽ tìm hiểu về những lợi ích và sự khác biệt giữa các phương pháp xử lý dữ liệu thời gian thực thông qua Spark.
Spark SQL là một thành phần quan trọng của Apache Spark, cung cấp khả năng xử lý dữ liệu lớn thông qua việc sử dụng SQL. Bài viết này sẽ giúp bạn khám phá Spark SQL chi tiết, từ câu hỏi "Spark SQL là gì?" đến cách chạy các truy vấn với hiệu suất cao thông qua Catalyst optimizer và ví dụ thực tế.
Apache Spark là nền tảng xử lý dữ liệu mạnh mẽ được ưa chuộng trong thế giới Big Data. Với các API như DataFrame và Dataset, Spark giúp xử lý dữ liệu dễ dàng và hiệu quả. Bài viết này sẽ khám phá sự khác biệt giữa DataFrame, Dataset và RDD, cùng với các trường hợp cụ thể để áp dụng mỗi loại trong công việc hằng ngày.
Trong kỷ nguyên dữ liệu lớn, Apache Spark nổi lên như một công cụ mạnh mẽ giúp xử lý dữ liệu phân tán hiệu quả. Tại trung tâm của Spark là RDD (Resilient Distributed Dataset), đóng vai trò quan trọng trong khả năng xử lý dữ liệu nhanh chóng và đáng tin cậy. Bài viết này sẽ khám phá chi tiết về RDD và các khía cạnh kỹ thuật liên quan.
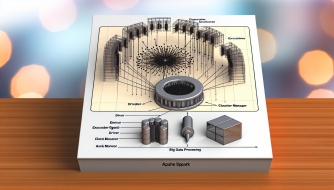
Apache Spark là một công cụ mạnh mẽ cho xử lý dữ liệu lớn. Bài viết này sẽ khám phá kiến trúc Spark với các thành phần chính như Driver, Executor, và cách chúng hoạt động trong một Cluster Manager. Qua đó, bạn sẽ hiểu rõ hơn về Workflow xử lý dữ liệu trong Spark.
Apache Spark là một nền tảng mã nguồn mở mạnh mẽ dành cho xử lý dữ liệu lớn. Nó mang lại khả năng xử lý dữ liệu nhanh chóng và hiệu quả, đặc biệt khi so sánh với các hệ thống như Hadoop. Bài viết này sẽ khám phá chi tiết về Apache Spark, từ kiến trúc cho đến ứng dụng thực tiễn.

Trong thời đại số hóa, việc tiếp cận và ứng dụng Digital Thinking đang trở thành yêu cầu thiết yếu đối với lãnh đạo. Bài viết này sẽ phân tích lý do tại sao kỹ năng này quan trọng và cách nó có thể hỗ trợ lãnh đạo trong việc ra quyết định dựa trên dữ liệu và quản trị tổ chức số hiệu quả.