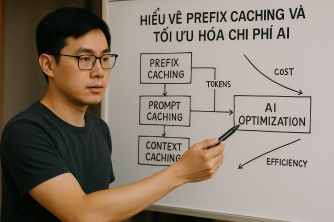
Trong bối cảnh AI ngày càng trở thành một phần không thể thiếu, việc tối ưu hóa chi phí trở nên quan trọng hơn bao giờ hết. Bài viết này sẽ đi sâu vào các khái niệm như Prefix Caching, Prompt Caching, và Context Caching, để hiểu cách chúng có thể giảm thiểu chi phí và tăng hiệu năng xử lý trong các hệ thống AI.
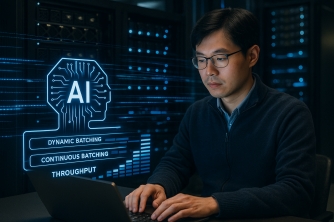
Trong thế giới trí tuệ nhân tạo ngày nay, tối ưu hóa hiệu suất là vô cùng quan trọng. Bài viết này sẽ khám phá cách Continuous Batching có thể cải thiện Throughput khi phục vụ LLM, đồng thời phân tích vai trò của GPU utilization và các yếu tố khác như Dynamic Batching và KV Cache.
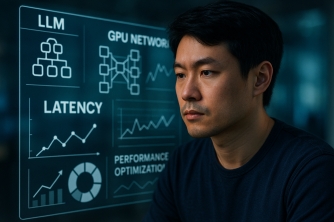
Inter-Token Latency (ITL) đóng vai trò quan trọng trong việc tối ưu hóa trải nghiệm người dùng khi tương tác với hệ thống AI. Trong bối cảnh những công nghệ như LLM, TPOT trở nên phổ biến, hiểu rõ và quản lý ITL hiệu quả là cần thiết để cải thiện hiệu suất phản hồi, giảm thiểu thời gian chờ đợi và nâng cao chất lượng dịch vụ.
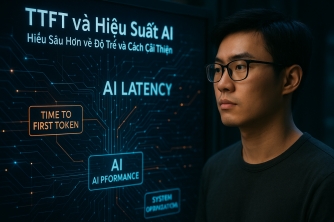
Thời gian để nhận được từ đầu tiên (TTFT) là một yếu tố quan trọng trong hiệu suất của các mô hình trí tuệ nhân tạo (AI). Trong bài viết này, chúng ta sẽ khám phá TTFT là gì, tầm quan trọng của nó, các yếu tố ảnh hưởng, và cách cải thiện TTFT trong các hệ thống AI khi triển khai vào sản xuất.
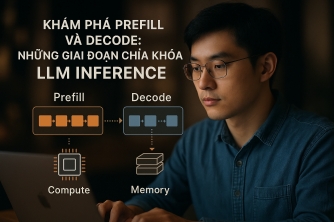
Trong thế giới của các mô hình ngôn ngữ lớn (LLM), hiểu rõ các giai đoạn Prefill và Decode là nền tảng để tối ưu hóa quá trình suy luận. Bài viết này sẽ đi sâu vào Prefill đối với Compute, Decode đối với Memory, và làm thế nào để tối ưu hóa hai giai đoạn này nhằm cải thiện hiệu năng LLM Inference.
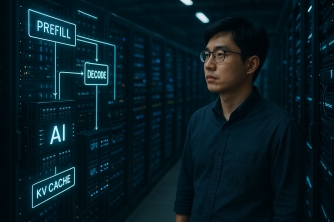
Disaggregated Inference đang thay đổi cách chúng ta tiếp cận inference cho LLM quy mô lớn, hướng đến kiến trúc linh hoạt và tối ưu. Trong bài viết này, chúng ta sẽ khám phá sự cần thiết của Disaggregated Inference, sự khác biệt giữa Prefill và Decode, và ảnh hưởng của nó đến latency, throughput, cùng những thách thức sản xuất mà nó đặt ra.
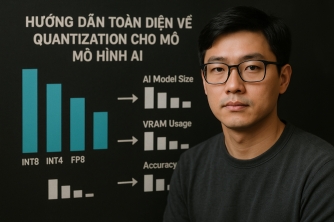
Trong bối cảnh công nghệ AI đang phát triển mạnh mẽ, quantization là một kỹ thuật không thể thiếu để tối ưu hoá mô hình và giảm thiểu chi phí vận hành. Bài viết này sẽ mang đến một cái nhìn toàn diện về quantization, bao gồm các mức độ chính xác (precision) và các kỹ thuật hiện đại như INT8, FP8, và Quantization-Aware Training.
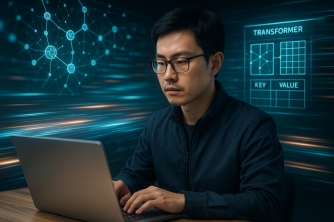
Trong thế giới AI hiện đại, KV Cache nổi lên như một công nghệ quan trọng giúp tối ưu hóa quá trình suy luận cho các mô hình ngôn ngữ lớn (LLM). Bài viết này sẽ khám phá sâu sắc KV Cache là gì, cách nó hỗ trợ transformer, và những lợi ích mà nó mang lại trong việc giảm độ trễ và tối ưu hóa hiệu suất.
Trong lĩnh vực trí tuệ nhân tạo, khái niệm về thời gian suy luận tăng cường đang ngày càng thu hút sự chú ý. Bài viết này sẽ khám phá khái niệm Inference-Time Scaling, phân biệt giữa quá trình huấn luyện và suy luận, cùng các luật tỷ lệ liên quan. Cùng tìm hiểu sâu hơn và khám phá ứng dụng thực tế của các khái niệm này.
Trong bối cảnh AI ngày càng phát triển, cách mà mô hình dành tài nguyên để suy nghĩ khi thực hiện các tác vụ là một chủ đề hấp dẫn. Bài viết này khám phá test-time compute và các khái niệm liên quan, từ đó giúp hiểu rõ hơn về cách thức xử lý thông tin và ra quyết định của trí tuệ nhân tạo.