Trong thời đại số hóa hiện nay, AI không chỉ là công nghệ tiên tiến mà còn mang lại sự thay đổi lớn trong cách thức vận hành kinh tế. Bài viết này đi sâu vào vai trò của chi phí suy luận trong AI và so sánh với chi phí huấn luyện, đồng thời tìm hiểu cách tối ưu hóa chi phí qua các yếu tố liên quan như kích thước mô hình và cách sử dụng GPU.
Trong bối cảnh AI ngày càng phức tạp và chi phí cao, FinOps xuất hiện như một giải pháp hữu hiệu để quản lý và tối ưu hóa chi phí liên quan. Bài viết này sẽ khám phá FinOps cho AI, cùng các yếu tố ảnh hưởng đến chi phí như GPU, token, và chi phí inference trong doanh nghiệp.
AI Runtime đóng vai trò quan trọng trong hoạt động của các ứng dụng AI hiện đại. Nó không chỉ quản lý quá trình thực thi của mô hình mà còn đảm bảo tính an toàn và hiệu suất. Bài viết này sẽ giải thích các khía cạnh của Runtime trong AI và tầm quan trọng của nó trong doanh nghiệp.
AI Inference Engine đóng vai trò quan trọng trong việc vận hành các mô hình machine learning. Đặc biệt, với sự phát triển của các LLM (Large Language Models), lựa chọn một inference engine hiệu quả là cần thiết để đảm bảo hiệu suất và hiệu quả tổng thể. Bài viết này sẽ khám phá cơ chế của inference engine và giới thiệu các công nghệ liên quan như vLLM, SGLang và TensorRT LLM.
Trong bài viết này, chúng ta sẽ khám phá cách xử lý context cực dài trong AI bằng cách áp dụng các kỹ thuật tiên tiến như Context Parallelism và Distributed Attention. Việc quản lý và xử lý thông tin từ các context lớn đòi hỏi sự hiểu biết sâu sắc về các công nghệ liên quan và cách chúng hoạt động trong môi trường tính toán phân tán.
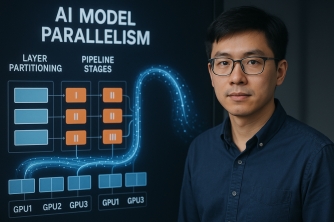
Trong thời đại AI hiện nay, việc tối ưu hóa huấn luyện và suy luận của các mô hình lớn là cần thiết. Trong bài viết này, chúng ta sẽ khám phá Pipeline Parallelism và các khía cạnh liên quan như Layer Partitioning và Hybrid Parallelism để hiểu rõ hơn về các phương pháp phân tán hiệu quả này.
Trong thế giới AI hiện đại, sự cần thiết của việc phân tán tính toán qua nhiều GPU trở nên cấp thiết để xử lý các mô hình lớn. Tensor Parallelism nổi bật với khả năng tăng tốc quà trình này. Cùng tìm hiểu cách Tensor Parallelism hoạt động và những lợi ích của việc ứng dụng nó cho mô hình lớn trên nhiều GPU.
Trong thời đại AI phát triển, Expert Parallelism nổi lên như một giải pháp tối ưu cho mô hình Mixture of Experts (MoE). Bài viết này sẽ đi sâu tìm hiểu cách Expert Parallelism hỗ trợ MoE bằng cách tối ưu hóa việc phân phối các tác vụ trên nhiều GPU, từ đó nâng cao hiệu suất và khả năng mở rộng cho hệ thống AI phân tán.
Trong thế giới học máy, kỹ thuật Attention đóng vai trò quan trọng trong việc cải thiện hiệu suất của các mô hình ngôn ngữ lớn (LLM). Gần đây, FlashAttention đã nổi lên như một phương pháp tiếp cận mới, giúp tối ưu hóa tới hạn bộ nhớ GPU và tăng tốc quá trình huấn luyện và suy luận. Bài viết này sẽ khám phá chi tiết về FlashAttention và các ứng dụng của nó.
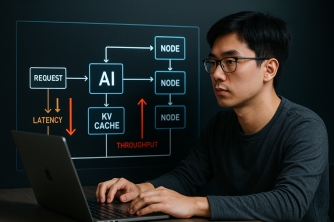
Trong thế giới hiện đại của AI, tối ưu hóa điều phối request là vô cùng quan trọng để đảm bảo hiệu suất cao. Một công nghệ đang nổi bật là KV-Aware Routing, cung cấp khả năng điều phối request thông minh dựa trên KV Cache. Bài viết này sẽ khám phá cách này và các lợi ích của nó trong việc tăng cường hiệu suất hệ thống AI.