Trong bối cảnh mô hình ngôn ngữ lớn (LLM) ngày càng phức tạp, quản lý bộ nhớ trở thành thách thức quan trọng. PagedAttention và vLLM là các công nghệ tiên tiến giúp tối ưu hóa việc sử dụng bộ nhớ. Bài viết này sẽ đi sâu vào cách giải pháp này cải thiện hiệu suất bộ nhớ, tăng cường khả năng xử lý và độ chính xác của LLM.
Giao tiếp giữa các mô hình AI không chỉ là vấn đề của việc xử lý văn bản. Công nghệ Cache-to-Cache (C2C) mang lại khả năng giao tiếp hiệu quả giữa các mô hình, vượt qua các giới hạn của văn bản. Khám phá cách C2C hoạt động, lợi ích và tiềm năng mà nó mang lại cho tương lai của AI.
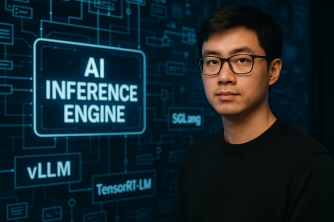
AI Inference Engine đóng vai trò quan trọng trong việc vận hành các mô hình machine learning. Đặc biệt, với sự phát triển của các LLM (Large Language Models), lựa chọn một inference engine hiệu quả là cần thiết để đảm bảo hiệu suất và hiệu quả tổng thể. Bài viết này sẽ khám phá cơ chế của inference engine và giới thiệu các công nghệ liên quan như vLLM, SGLang và TensorRT LLM.
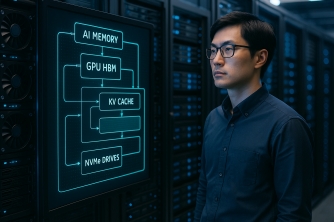
Trong kỷ nguyên AI hiện đại, sự tích hợp giữa các loại bộ nhớ như Tiered KV Cache, HBM, DRAM và NVMe đóng một vai trò quan trọng. Bài viết này sẽ khám phá cách tổ chức bộ nhớ tối ưu hóa từ mức cao đến thấp và vai trò của chúng trong phục vụ AI, từ đó cải thiện hiệu suất và giảm độ trễ.
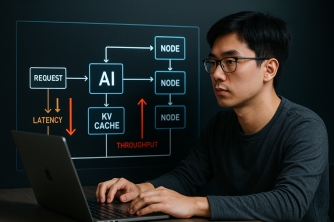
Trong thế giới hiện đại của AI, tối ưu hóa điều phối request là vô cùng quan trọng để đảm bảo hiệu suất cao. Một công nghệ đang nổi bật là KV-Aware Routing, cung cấp khả năng điều phối request thông minh dựa trên KV Cache. Bài viết này sẽ khám phá cách này và các lợi ích của nó trong việc tăng cường hiệu suất hệ thống AI.
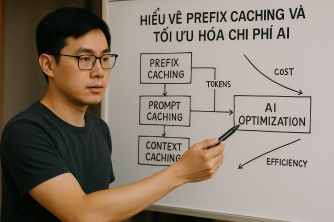
Trong bối cảnh AI ngày càng trở thành một phần không thể thiếu, việc tối ưu hóa chi phí trở nên quan trọng hơn bao giờ hết. Bài viết này sẽ đi sâu vào các khái niệm như Prefix Caching, Prompt Caching, và Context Caching, để hiểu cách chúng có thể giảm thiểu chi phí và tăng hiệu năng xử lý trong các hệ thống AI.
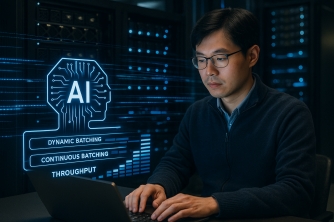
Trong thế giới trí tuệ nhân tạo ngày nay, tối ưu hóa hiệu suất là vô cùng quan trọng. Bài viết này sẽ khám phá cách Continuous Batching có thể cải thiện Throughput khi phục vụ LLM, đồng thời phân tích vai trò của GPU utilization và các yếu tố khác như Dynamic Batching và KV Cache.
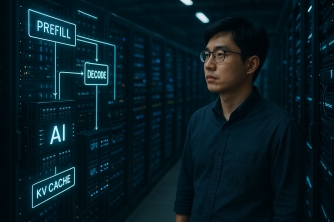
Disaggregated Inference đang thay đổi cách chúng ta tiếp cận inference cho LLM quy mô lớn, hướng đến kiến trúc linh hoạt và tối ưu. Trong bài viết này, chúng ta sẽ khám phá sự cần thiết của Disaggregated Inference, sự khác biệt giữa Prefill và Decode, và ảnh hưởng của nó đến latency, throughput, cùng những thách thức sản xuất mà nó đặt ra.
Trong thế giới AI hiện đại, KV Cache nổi lên như một công nghệ quan trọng giúp tối ưu hóa quá trình suy luận cho các mô hình ngôn ngữ lớn (LLM). Bài viết này sẽ khám phá sâu sắc KV Cache là gì, cách nó hỗ trợ transformer, và những lợi ích mà nó mang lại trong việc giảm độ trễ và tối ưu hóa hiệu suất.