AI alignment là một lĩnh vực quan trọng trong nghiên cứu AI, tập trung vào việc đảm bảo rằng các hệ thống AI hoạt động phù hợp với giá trị và mục tiêu của con người. Trong bài viết này, chúng ta sẽ khám phá các khái niệm như Outer Alignment, Inner Alignment, và khó khăn liên quan đến việc đạt được sự an toàn trong AI.
Direct Preference Optimization (DPO) là một phương pháp nổi bật trong quá trình huấn luyện mô hình ngôn ngữ lớn (LLM) nhằm tối ưu hóa sự ưa thích trực tiếp. Bài viết này khám phá sâu về DPO, cách nó hoạt động và so sánh với các phương pháp khác như RLHF và SFT, cùng với các ứng dụng thực tế và thách thức.
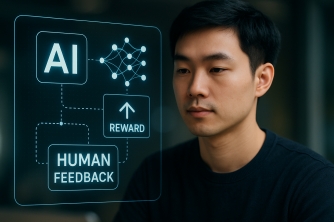
Học từ phản hồi của con người (RLHF) là một phương pháp tiên tiến trong đào tạo AI, cho phép các mô hình học từ phản hồi của con người để tạo ra những kết quả thông minh hơn và chính xác hơn. Phần này sẽ giới thiệu khái niệm RLHF và tại sao việc đào tạo chỉ bằng dữ liệu ban đầu là chưa đủ.