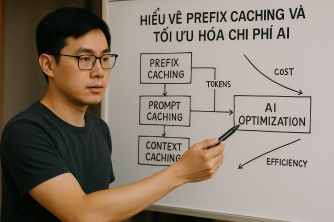
Trong bối cảnh AI ngày càng trở thành một phần không thể thiếu, việc tối ưu hóa chi phí trở nên quan trọng hơn bao giờ hết. Bài viết này sẽ đi sâu vào các khái niệm như Prefix Caching, Prompt Caching, và Context Caching, để hiểu cách chúng có thể giảm thiểu chi phí và tăng hiệu năng xử lý trong các hệ thống AI.
Trong thế giới AI hiện đại, KV Cache nổi lên như một công nghệ quan trọng giúp tối ưu hóa quá trình suy luận cho các mô hình ngôn ngữ lớn (LLM). Bài viết này sẽ khám phá sâu sắc KV Cache là gì, cách nó hỗ trợ transformer, và những lợi ích mà nó mang lại trong việc giảm độ trễ và tối ưu hóa hiệu suất.