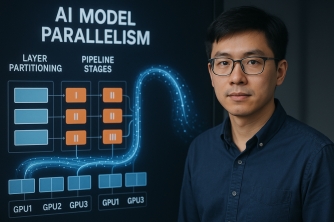
Trong thời đại AI hiện nay, việc tối ưu hóa huấn luyện và suy luận của các mô hình lớn là cần thiết. Trong bài viết này, chúng ta sẽ khám phá Pipeline Parallelism và các khía cạnh liên quan như Layer Partitioning và Hybrid Parallelism để hiểu rõ hơn về các phương pháp phân tán hiệu quả này.
Trong thế giới AI hiện đại, sự cần thiết của việc phân tán tính toán qua nhiều GPU trở nên cấp thiết để xử lý các mô hình lớn. Tensor Parallelism nổi bật với khả năng tăng tốc quà trình này. Cùng tìm hiểu cách Tensor Parallelism hoạt động và những lợi ích của việc ứng dụng nó cho mô hình lớn trên nhiều GPU.
Dữ liệu tự sinh đã và đang làm thay đổi sâu sắc cách thức AI phát triển, nhưng đằng sau đó là nguy cơ về sự sụp đổ của mô hình. Bài viết này sẽ đi sâu vào những rủi ro tiềm ẩn từ việc sử dụng dữ liệu do AI tạo ra và cách quản lý những thách thức này hiệu quả.
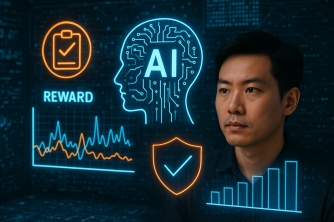
Trong lĩnh vực trí tuệ nhân tạo, **reward hacking** là hiện tượng khi AI tối ưu hóa mục tiêu theo cách không mong muốn, dẫn đến việc đạt điểm cao nhưng làm sai mục tiêu. Điều này có thể gây ra hậu quả nghiêm trọng nếu không được kiểm soát tốt. Bài viết này khám phá các khái niệm liên quan và cách kiểm soát để đảm bảo an toàn AI.
Trong thời đại số hóa toàn cầu, AI chủ quyền đang trở thành một vấn đề quan trọng của các quốc gia. Từ việc kiểm soát dữ liệu đến xây dựng hạ tầng và lĩnh vực AI riêng biệt, chủ quyền AI đại diện cho quyền tự chủ và an ninh quốc gia trong thế giới kỹ thuật số.
Trí tuệ nhân tạo đang dần thay đổi cách chúng ta tương tác với công nghệ, nhờ vào sự phát triển của các mô hình thế giới (World Model). Những mô hình này cho phép AI hiểu và dự đoán các tình huống trong môi trường thực tế, từ đó cải thiện khả năng xử lý của hệ thống trong các ứng dụng như robotics và tự lái xe.
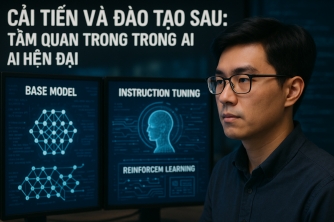
Trong thời đại AI phát triển vượt bậc, quá trình đào tạo sau (post-training) đóng vai trò quan trọng trong việc biến các mô hình cơ bản thành công cụ AI tinh vi. Bài viết này sẽ giúp bạn hiểu rõ sự khác biệt giữa giai đoạn huấn luyện trước và sau, cùng các phương pháp như RLHF, SFT, và DPO nhằm tối ưu hóa khả năng của mô hình AI.
Group Relative Policy Optimization (GRPO) đang trở thành một phần không thể thiếu trong học tăng cường, đặc biệt trong việc huấn luyện các mô hình lập luận nhân tạo. Bài viết này sẽ khám phá cách GRPO hoạt động, so sánh lợi ích của nó với các phương pháp tương tự như PPO và DPO, và tại sao nó nhận được sự chú ý đặc biệt.
Học từ phản hồi của con người (RLHF) là một phương pháp tiên tiến trong đào tạo AI, cho phép các mô hình học từ phản hồi của con người để tạo ra những kết quả thông minh hơn và chính xác hơn. Phần này sẽ giới thiệu khái niệm RLHF và tại sao việc đào tạo chỉ bằng dữ liệu ban đầu là chưa đủ.
Trong lĩnh vực tìm kiếm thông tin, các thuật toán xếp hạng lại (reranking) ngày càng trở nên quan trọng để cải thiện độ chính xác của kết quả tìm kiếm. Bài viết này khám phá cách hoạt động của reranker, từ mô hình cross-encoder đến ứng dụng trong RAG, nhằm giúp bạn hiểu rõ hơn về tầm quan trọng của chúng.