AI Tokenomics và kinh tế học token trong doanh nghiệp AI là một lĩnh vực phức tạp ảnh hưởng đến chi phí và hiệu suất. Bài viết này sẽ giúp bạn hiểu rõ hơn về các yếu tố liên quan đến chi phí tác vụ AI và cách tối ưu hóa chúng để đạt hiệu quả cao nhất trong doanh nghiệp.
Trong kỷ nguyên AI hiện nay, chọn lựa model AI phù hợp cho từng tác vụ là điều cần thiết để đảm bảo hiệu suất và tối ưu chi phí. Khái niệm 'Model Router' đã nổi lên như một giải pháp thông minh giúp điều hướng và lựa chọn model phù hợp dựa trên yêu cầu cụ thể của từng ứng dụng.
Trong thế giới học máy, kỹ thuật Attention đóng vai trò quan trọng trong việc cải thiện hiệu suất của các mô hình ngôn ngữ lớn (LLM). Gần đây, FlashAttention đã nổi lên như một phương pháp tiếp cận mới, giúp tối ưu hóa tới hạn bộ nhớ GPU và tăng tốc quá trình huấn luyện và suy luận. Bài viết này sẽ khám phá chi tiết về FlashAttention và các ứng dụng của nó.
Semantic Cache đang trở thành một công cụ đắc lực trong việc tối ưu hóa phản hồi của AI. Bằng cách lưu trữ và truy xuất thông tin theo ngữ nghĩa, nó giúp giảm chi phí và tăng hiệu quả. Bài viết này sẽ khám phá các khía cạnh khác nhau của Semantic Cache và so sánh với các hình thức cache truyền thống.
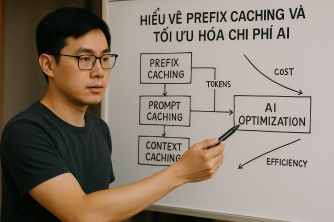
Trong bối cảnh AI ngày càng trở thành một phần không thể thiếu, việc tối ưu hóa chi phí trở nên quan trọng hơn bao giờ hết. Bài viết này sẽ đi sâu vào các khái niệm như Prefix Caching, Prompt Caching, và Context Caching, để hiểu cách chúng có thể giảm thiểu chi phí và tăng hiệu năng xử lý trong các hệ thống AI.
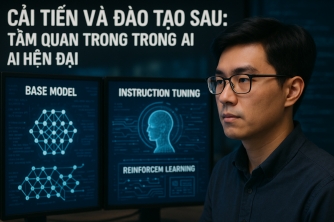
Trong thời đại AI phát triển vượt bậc, quá trình đào tạo sau (post-training) đóng vai trò quan trọng trong việc biến các mô hình cơ bản thành công cụ AI tinh vi. Bài viết này sẽ giúp bạn hiểu rõ sự khác biệt giữa giai đoạn huấn luyện trước và sau, cùng các phương pháp như RLHF, SFT, và DPO nhằm tối ưu hóa khả năng của mô hình AI.
Group Relative Policy Optimization (GRPO) đang trở thành một phần không thể thiếu trong học tăng cường, đặc biệt trong việc huấn luyện các mô hình lập luận nhân tạo. Bài viết này sẽ khám phá cách GRPO hoạt động, so sánh lợi ích của nó với các phương pháp tương tự như PPO và DPO, và tại sao nó nhận được sự chú ý đặc biệt.
Direct Preference Optimization (DPO) là một phương pháp nổi bật trong quá trình huấn luyện mô hình ngôn ngữ lớn (LLM) nhằm tối ưu hóa sự ưa thích trực tiếp. Bài viết này khám phá sâu về DPO, cách nó hoạt động và so sánh với các phương pháp khác như RLHF và SFT, cùng với các ứng dụng thực tế và thách thức.
Trong thế giới AI, tối ưu hóa mô hình ngôn ngữ lớn (LLM) là một thách thức đáng kể về chi phí và tài nguyên. Phương pháp Low-Rank Adaptation (LoRA) và Parameter Efficient Fine-Tuning (PEFT) đã nổi lên như là giải pháp tiềm năng, giảm thiểu chi phí mà vẫn duy trì hiệu suất cao. Bài viết này sẽ khám phá sâu sắc các khía cạnh của LoRA và PEFT.
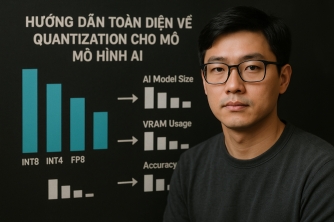
Trong bối cảnh công nghệ AI đang phát triển mạnh mẽ, quantization là một kỹ thuật không thể thiếu để tối ưu hoá mô hình và giảm thiểu chi phí vận hành. Bài viết này sẽ mang đến một cái nhìn toàn diện về quantization, bao gồm các mức độ chính xác (precision) và các kỹ thuật hiện đại như INT8, FP8, và Quantization-Aware Training.