AI Inference Engine đóng vai trò quan trọng trong việc vận hành các mô hình machine learning. Đặc biệt, với sự phát triển của các LLM (Large Language Models), lựa chọn một inference engine hiệu quả là cần thiết để đảm bảo hiệu suất và hiệu quả tổng thể. Bài viết này sẽ khám phá cơ chế của inference engine và giới thiệu các công nghệ liên quan như vLLM, SGLang và TensorRT LLM.
Trong thế giới của máy học, việc tối ưu hóa mô hình lớn trên phần cứng hạn chế là một thách thức đáng kể. Với QLoRA, quá trình fine-tuning mô hình ngôn ngữ lớn (LLM) đã trở nên khả thi hơn. Bài viết này sẽ đi sâu tìm hiểu về QLoRA, từ định nghĩa, cách hoạt động đến những đột phá nó mang lại.
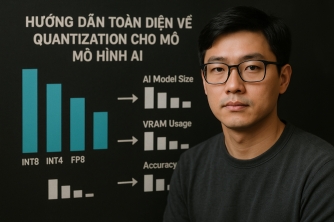
Trong bối cảnh công nghệ AI đang phát triển mạnh mẽ, quantization là một kỹ thuật không thể thiếu để tối ưu hoá mô hình và giảm thiểu chi phí vận hành. Bài viết này sẽ mang đến một cái nhìn toàn diện về quantization, bao gồm các mức độ chính xác (precision) và các kỹ thuật hiện đại như INT8, FP8, và Quantization-Aware Training.
Trong lĩnh vực trí tuệ nhân tạo, hiệu suất là yếu tố then chốt để vận hành các mô hình một cách hiệu quả. Các công nghệ như ONNX và kỹ thuật quantization đóng một vai trò quan trọng trong việc chuyển đổi và tối ưu hóa mô hình. Bài viết này sẽ lần lượt khám phá từng bước trong quá trình tối ưu hóa từ chuyển đổi mô hình đến tối ưu I/O.