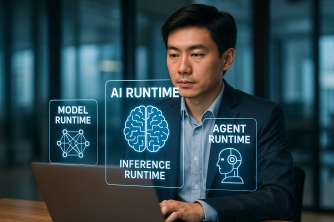
AI Runtime đóng vai trò quan trọng trong hoạt động của các ứng dụng AI hiện đại. Nó không chỉ quản lý quá trình thực thi của mô hình mà còn đảm bảo tính an toàn và hiệu suất. Bài viết này sẽ giải thích các khía cạnh của Runtime trong AI và tầm quan trọng của nó trong doanh nghiệp.
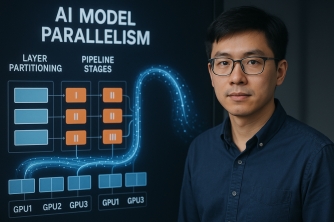
Trong thời đại AI hiện nay, việc tối ưu hóa huấn luyện và suy luận của các mô hình lớn là cần thiết. Trong bài viết này, chúng ta sẽ khám phá Pipeline Parallelism và các khía cạnh liên quan như Layer Partitioning và Hybrid Parallelism để hiểu rõ hơn về các phương pháp phân tán hiệu quả này.
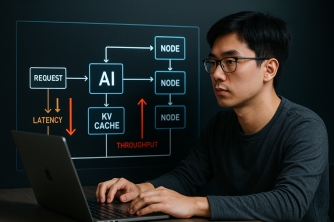
Trong thế giới hiện đại của AI, tối ưu hóa điều phối request là vô cùng quan trọng để đảm bảo hiệu suất cao. Một công nghệ đang nổi bật là KV-Aware Routing, cung cấp khả năng điều phối request thông minh dựa trên KV Cache. Bài viết này sẽ khám phá cách này và các lợi ích của nó trong việc tăng cường hiệu suất hệ thống AI.
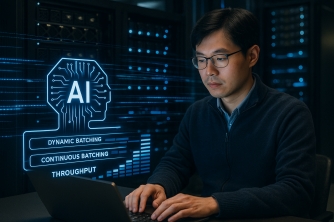
Trong thế giới trí tuệ nhân tạo ngày nay, tối ưu hóa hiệu suất là vô cùng quan trọng. Bài viết này sẽ khám phá cách Continuous Batching có thể cải thiện Throughput khi phục vụ LLM, đồng thời phân tích vai trò của GPU utilization và các yếu tố khác như Dynamic Batching và KV Cache.
Inter-Token Latency (ITL) đóng vai trò quan trọng trong việc tối ưu hóa trải nghiệm người dùng khi tương tác với hệ thống AI. Trong bối cảnh những công nghệ như LLM, TPOT trở nên phổ biến, hiểu rõ và quản lý ITL hiệu quả là cần thiết để cải thiện hiệu suất phản hồi, giảm thiểu thời gian chờ đợi và nâng cao chất lượng dịch vụ.
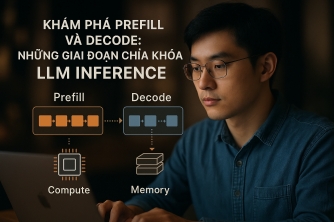
Trong thế giới của các mô hình ngôn ngữ lớn (LLM), hiểu rõ các giai đoạn Prefill và Decode là nền tảng để tối ưu hóa quá trình suy luận. Bài viết này sẽ đi sâu vào Prefill đối với Compute, Decode đối với Memory, và làm thế nào để tối ưu hóa hai giai đoạn này nhằm cải thiện hiệu năng LLM Inference.
Disaggregated Inference đang thay đổi cách chúng ta tiếp cận inference cho LLM quy mô lớn, hướng đến kiến trúc linh hoạt và tối ưu. Trong bài viết này, chúng ta sẽ khám phá sự cần thiết của Disaggregated Inference, sự khác biệt giữa Prefill và Decode, và ảnh hưởng của nó đến latency, throughput, cùng những thách thức sản xuất mà nó đặt ra.
Cơ chế giải thích đang trở thành một phần quan trọng trong nghiên cứu trí tuệ nhân tạo, mở ra cơ hội cho việc kiểm soát và phát triển AI an toàn hơn. Bài viết này khám phá các khái niệm cốt lõi như giải thích cơ học của mạng nơ-ron, sự khác biệt giữa giải thích và giải nghĩa, cũng như tầm quan trọng của chúng đối với an toàn AI.
Trong thời đại số hóa toàn cầu, AI chủ quyền đang trở thành một vấn đề quan trọng của các quốc gia. Từ việc kiểm soát dữ liệu đến xây dựng hạ tầng và lĩnh vực AI riêng biệt, chủ quyền AI đại diện cho quyền tự chủ và an ninh quốc gia trong thế giới kỹ thuật số.
Browser Agent và trình duyệt tự động đang ngày càng trở thành một phần quan trọng trong việc thực hiện tác vụ trực tuyến. Bài viết này khám phá sự khác biệt giữa browser automation truyền thống và AI Browser Agent, đồng thời tìm hiểu các khía cạnh kỹ thuật quan trọng như bảo mật và áp dụng trong thế giới thực.