Trong thế giới hiện đại, nhu cầu tóm tắt văn bản ngày càng gia tăng. Giải pháp lựa chọn đúng model cùng các bước chuẩn hóa dữ liệu, fine-tuning, và đánh giá là rất quan trọng. Bài viết này sẽ hướng dẫn chi tiết từ bước chọn lựa T5, BART hoặc mT5, đến quy trình đánh giá hiệu quả của các mô hình qua ROUGE.
Trong bài viết này, chúng ta sẽ tìm hiểu về công nghệ BERTopic, một phương pháp hiện đại mạnh mẽ để phân tích chủ đề trong văn bản. Bằng cách kết hợp các kỹ thuật như embeddings, UMAP và HDBSCAN, BERTopic giúp chúng ta khai thác ý nghĩa ngữ nghĩa từ dữ liệu văn bản một cách hiệu quả và trực quan.
Trong bối cảnh công nghệ thông tin phát triển, các phương pháp gán nhãn thực thể (NER) trở nên thiết yếu cho việc trích xuất thông tin từ văn bản. Bài viết này sẽ hướng dẫn chi tiết cách sử dụng spaCy, một thư viện mạnh mẽ cho xử lý ngôn ngữ tự nhiên, cùng với Label Studio để thực hiện NER.
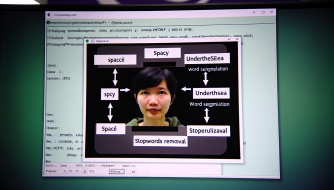
Trong kỷ nguyên số, xử lý ngôn ngữ tự nhiên đóng vai trò quan trọng trong việc phát triển các ứng dụng thông minh. Bài viết này khám phá các công cụ nổi bật như spaCy, Underthesea và VnCoreNLP, đồng thời hướng dẫn quy trình tiền xử lý văn bản gồm thu thập dữ liệu, chuẩn hoá, tách từ, loại stopwords và lưu trữ quy trình để tái sử dụng.
Trong lĩnh vực xử lý ngôn ngữ tự nhiên, mô hình Seq2Seq và cơ chế Attention đã trở thành công cụ không thể thiếu trong việc dịch thuật và tóm tắt văn bản. Những cải tiến này đã cải thiện đáng kể độ chính xác và tốc độ của các ứng dụng dịch máy, nhờ vào khả năng học hỏi các phụ thuộc ngữ nghĩa và ngữ cảnh phức tạp.
Mô hình chủ đề là công cụ quan trọng trong xử lý ngôn ngữ tự nhiên giúp phát hiện cấu trúc ngữ nghĩa tiềm ẩn trong tài liệu. Trong đó, Latent Dirichlet Allocation (LDA) nổi bật với khả năng gom nhóm từ ngữ thành các 'chủ đề'. Bài viết này sẽ đi sâu vào các phương pháp trực giác LDA, đánh giá độ coherence, và ứng dụng trong phân cụm nội dung.
Nhận dạng thực thể có tên (NER) là một phần của trí tuệ nhân tạo, giúp xác định và phân loại các thực thể trong văn bản không cấu trúc. Bài viết này sẽ đi sâu vào NER, so sánh mô hình CRF với Transformer, và khám phá các ứng dụng thực tiễn trong thế giới công nghệ ngày nay.
Trong xử lý ngôn ngữ tự nhiên, các kỹ thuật như gắn nhãn từ loại và cú pháp phụ thuộc là những công cụ quan trọng giúp máy tính hiểu và phân tích ngữ nghĩa văn bản. Bài viết này sẽ khám phá cách các kỹ thuật này hoạt động và vai trò của chúng trong việc phát triển các ứng dụng xử lý ngôn ngữ hiện đại.
Biểu thức chính quy (Regex) là công cụ mạnh mẽ trong lập trình, đặc biệt trong lĩnh vực xử lý ngôn ngữ tự nhiên. Bài viết này sẽ giải thích cú pháp regex thông dụng, cách trích xuất mẫu hiệu quả, và những cạm bẫy cần tránh khi sử dụng regex trong các ứng dụng lập trình thực tiễn.
N-gram, smoothing và perplexity là các khái niệm quan trọng trong xử lý ngôn ngữ tự nhiên, giúp các mô hình hiểu và dự đoán ngôn ngữ một cách chính xác hơn. Trong bài viết này, chúng ta sẽ khám phá sâu hơn về các khái niệm này, qua đó nâng cao hiểu biết về khả năng áp dụng của chúng trong ngữ cảnh tiếng Việt.