Trong bài viết này, chúng ta sẽ khám phá cách xử lý context cực dài trong AI bằng cách áp dụng các kỹ thuật tiên tiến như Context Parallelism và Distributed Attention. Việc quản lý và xử lý thông tin từ các context lớn đòi hỏi sự hiểu biết sâu sắc về các công nghệ liên quan và cách chúng hoạt động trong môi trường tính toán phân tán.
Trong bối cảnh công nghệ phát triển không ngừng, sự xuất hiện của AI đã mở ra nhiều tiềm năng mới nhưng đồng thời cũng tạo ra những thách thức lớn về an ninh mạng. Những cảnh báo từ Bill Gates và Hiếu PC nhấn mạnh tầm quan trọng của việc bảo vệ dữ liệu trong thời kỳ công nghệ số và ngăn chặn các cuộc tấn công mạng từ thế hệ tội phạm công nghệ giá rẻ.
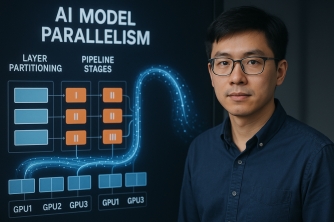
Trong thời đại AI hiện nay, việc tối ưu hóa huấn luyện và suy luận của các mô hình lớn là cần thiết. Trong bài viết này, chúng ta sẽ khám phá Pipeline Parallelism và các khía cạnh liên quan như Layer Partitioning và Hybrid Parallelism để hiểu rõ hơn về các phương pháp phân tán hiệu quả này.
Trung Quốc đang nổi lên như một thế lực đáng gờm trong lĩnh vực trí tuệ nhân tạo (AI). Bằng việc liên tục cho ra đời các mô hình AI mới, nâng cấp công nghệ dày đặc và giá dịch vụ hợp lí, Trung Quốc đang tạo ra sự cạnh tranh gay gắt với các quốc gia khác. Bài viết sẽ phân tích sâu hơn về các chiến lược và tác động của sự bùng nổ này.
Trong thời đại AI phát triển, Expert Parallelism nổi lên như một giải pháp tối ưu cho mô hình Mixture of Experts (MoE). Bài viết này sẽ đi sâu tìm hiểu cách Expert Parallelism hỗ trợ MoE bằng cách tối ưu hóa việc phân phối các tác vụ trên nhiều GPU, từ đó nâng cao hiệu suất và khả năng mở rộng cho hệ thống AI phân tán.
Trong thế giới học máy, kỹ thuật Attention đóng vai trò quan trọng trong việc cải thiện hiệu suất của các mô hình ngôn ngữ lớn (LLM). Gần đây, FlashAttention đã nổi lên như một phương pháp tiếp cận mới, giúp tối ưu hóa tới hạn bộ nhớ GPU và tăng tốc quá trình huấn luyện và suy luận. Bài viết này sẽ khám phá chi tiết về FlashAttention và các ứng dụng của nó.
Trong thời đại công nghệ, AI đã trở thành một phần không thể thiếu. Tuy nhiên, cùng với sự phát triển đó là những thách thức về an toàn mà AI bất hảo gây ra. Bài viết này khám phá những vấn đề nổi bật như Claude AI lừa đảo cảnh sát, cảnh báo từ Hiếu PC về tội phạm mạng AI, và chương trình thạc sĩ AIoT của FPT.
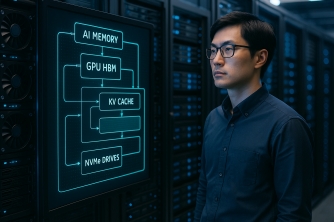
Trong kỷ nguyên AI hiện đại, sự tích hợp giữa các loại bộ nhớ như Tiered KV Cache, HBM, DRAM và NVMe đóng một vai trò quan trọng. Bài viết này sẽ khám phá cách tổ chức bộ nhớ tối ưu hóa từ mức cao đến thấp và vai trò của chúng trong phục vụ AI, từ đó cải thiện hiệu suất và giảm độ trễ.
Trong thời đại mà trí tuệ nhân tạo (AI) đang ngày càng phổ biến, các nhà sáng tạo đối diện với thách thức phải chứng minh sáng tạo của mình là sản phẩm của trí óc con người chứ không phải máy móc. Với những nghi ngờ về sự can thiệp của AI và những lỗi sai chính tả, quá trình sáng tạo cần được ghi lại và bảo vệ một cách hợp pháp.
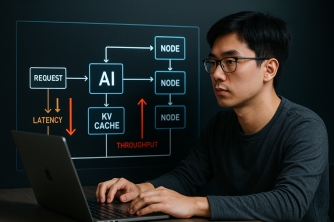
Trong thế giới hiện đại của AI, tối ưu hóa điều phối request là vô cùng quan trọng để đảm bảo hiệu suất cao. Một công nghệ đang nổi bật là KV-Aware Routing, cung cấp khả năng điều phối request thông minh dựa trên KV Cache. Bài viết này sẽ khám phá cách này và các lợi ích của nó trong việc tăng cường hiệu suất hệ thống AI.