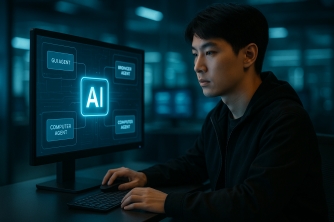
Sự phát triển nhanh chóng của trí tuệ nhân tạo (AI) đang mở ra những khả năng mới trong việc điều khiển máy tính, từ sử dụng giao diện người dùng trực quan cho đến quản lý các tác vụ phức tạp. Trong bài viết này, chúng ta sẽ khám phá chi tiết về cách AI có thể tự sử dụng máy tính và những tiềm năng đặc biệt của nó.
Dữ liệu tổng hợp đang trở thành một phần không thể thiếu của công nghệ AI hiện đại. Từ việc cải thiện độ chính xác của các mô hình học máy, cho đến giảm thiểu các rủi ro liên quan đến quyền riêng tư, dữ liệu tổng hợp mang lại nhiều lợi ích cho việc phát triển công nghệ AI. Trong bài viết này, chúng ta sẽ khám phá chi tiết về dữ liệu tổng hợp, từ khái niệm cơ bản đến các ứng dụng thực tiễn.
iPhone 18 Pro là một trong những sản phẩm cao cấp của Apple, nhưng không thoát khỏi một số vấn đề thường gặp như sự cố phai màu, tróc sơn, và các vấn đề liên quan đến camera. Bài viết này sẽ giúp bạn hiểu rõ những sự cố này và cách phòng tránh để bảo vệ chiếc điện thoại đắt tiền của mình.
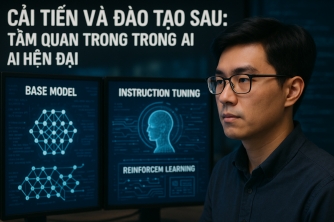
Trong thời đại AI phát triển vượt bậc, quá trình đào tạo sau (post-training) đóng vai trò quan trọng trong việc biến các mô hình cơ bản thành công cụ AI tinh vi. Bài viết này sẽ giúp bạn hiểu rõ sự khác biệt giữa giai đoạn huấn luyện trước và sau, cùng các phương pháp như RLHF, SFT, và DPO nhằm tối ưu hóa khả năng của mô hình AI.
Group Relative Policy Optimization (GRPO) đang trở thành một phần không thể thiếu trong học tăng cường, đặc biệt trong việc huấn luyện các mô hình lập luận nhân tạo. Bài viết này sẽ khám phá cách GRPO hoạt động, so sánh lợi ích của nó với các phương pháp tương tự như PPO và DPO, và tại sao nó nhận được sự chú ý đặc biệt.
Khi công nghệ AI ngày càng phát triển, nó không chỉ mang lại lợi ích mà còn tạo ra những rủi ro lớn cho an ninh mạng, đặc biệt trong lĩnh vực ngân hàng. Các hacker đã bắt đầu sử dụng AI để thực hiện các cuộc tấn công tinh vi, buộc các ngân hàng phải tìm kiếm giải pháp bảo vệ thông tin người dùng một cách hiệu quả hơn.
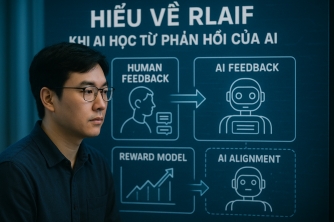
RLAIF (Reinforcement Learning from AI Feedback) là một phương pháp tiên tiến trong lĩnh vực AI, cho phép máy học từ phản hồi của chính AI. Khái niệm này được so sánh với phương pháp RLHF truyền thống. Bài viết sẽ khám phá các yếu tố của RLAIF, từ mô hình phần thưởng đến khía cạnh tương lai của AI.
Trí tuệ nhân tạo (AI) đang ngày càng ảnh hưởng sâu sắc đến cách chúng ta hiểu và tương tác với thế giới tự nhiên. Một chủ đề đáng chú ý là sự xâm phạm quyền riêng tư của động vật thông qua việc giải mã tiếng kêu của chúng. Trong bài viết này, chúng tôi sẽ khám phá những vấn đề đạo đức và công nghệ xung quanh chủ đề này.
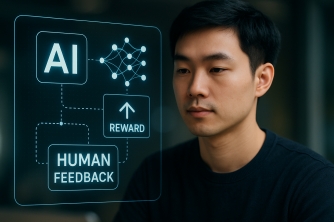
Học từ phản hồi của con người (RLHF) là một phương pháp tiên tiến trong đào tạo AI, cho phép các mô hình học từ phản hồi của con người để tạo ra những kết quả thông minh hơn và chính xác hơn. Phần này sẽ giới thiệu khái niệm RLHF và tại sao việc đào tạo chỉ bằng dữ liệu ban đầu là chưa đủ.
Trong bối cảnh AI đang phát triển mạnh mẽ, sự kiện lãnh đạo an toàn của OpenAI nghỉ việc đã gây ra nhiều tranh cãi về văn hóa công ty và tốc độ phát triển của mô hình AI. Bài viết này sẽ khám phá sâu hơn về những ảnh hưởng của sự việc này đến ngành công nghiệp AI và các bên liên quan.