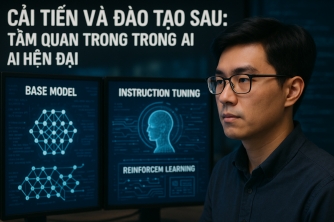
Trong thời đại AI phát triển vượt bậc, quá trình đào tạo sau (post-training) đóng vai trò quan trọng trong việc biến các mô hình cơ bản thành công cụ AI tinh vi. Bài viết này sẽ giúp bạn hiểu rõ sự khác biệt giữa giai đoạn huấn luyện trước và sau, cùng các phương pháp như RLHF, SFT, và DPO nhằm tối ưu hóa khả năng của mô hình AI.
Group Relative Policy Optimization (GRPO) đang trở thành một phần không thể thiếu trong học tăng cường, đặc biệt trong việc huấn luyện các mô hình lập luận nhân tạo. Bài viết này sẽ khám phá cách GRPO hoạt động, so sánh lợi ích của nó với các phương pháp tương tự như PPO và DPO, và tại sao nó nhận được sự chú ý đặc biệt.
Direct Preference Optimization (DPO) là một phương pháp nổi bật trong quá trình huấn luyện mô hình ngôn ngữ lớn (LLM) nhằm tối ưu hóa sự ưa thích trực tiếp. Bài viết này khám phá sâu về DPO, cách nó hoạt động và so sánh với các phương pháp khác như RLHF và SFT, cùng với các ứng dụng thực tế và thách thức.

Công nghệ blockchain đang tạo ra sự chuyển đổi mạnh mẽ trong nhiều lĩnh vực. Hiểu rõ các giao thức đồng thuận như PoW, PoS, và DPoS là chìa khóa để khai thác tối đa lợi ích mà blockchain mang lại. Bài viết này sẽ khám phá chi tiết từng giao thức, so sánh ưu nhược điểm, và đánh giá xu hướng phát triển trong tương lai của công nghệ này.

Delegated Proof of Stake (DPoS) là một cơ chế đồng thuận trong lĩnh vực blockchain nổi bật nhờ vào khả năng tối ưu hóa hiệu suất xử lý và duy trì tính phi tập trung. Bài viết này sẽ khám phá cách thức hoạt động, sự khác biệt giữa DPoS và PoS, ưu nhược điểm cũng như những ứng dụng nổi bật của DPoS trên các blockchain như EOS và Tezos.