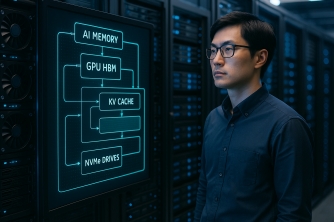
Trong kỷ nguyên AI hiện đại, sự tích hợp giữa các loại bộ nhớ như Tiered KV Cache, HBM, DRAM và NVMe đóng một vai trò quan trọng. Bài viết này sẽ khám phá cách tổ chức bộ nhớ tối ưu hóa từ mức cao đến thấp và vai trò của chúng trong phục vụ AI, từ đó cải thiện hiệu suất và giảm độ trễ.
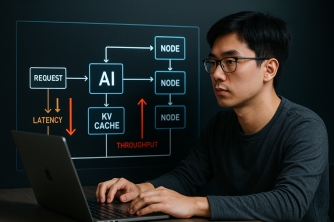
Trong thế giới hiện đại của AI, tối ưu hóa điều phối request là vô cùng quan trọng để đảm bảo hiệu suất cao. Một công nghệ đang nổi bật là KV-Aware Routing, cung cấp khả năng điều phối request thông minh dựa trên KV Cache. Bài viết này sẽ khám phá cách này và các lợi ích của nó trong việc tăng cường hiệu suất hệ thống AI.
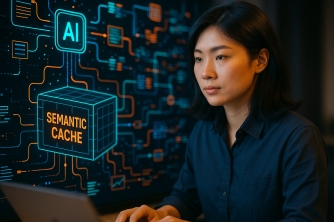
Semantic Cache đang trở thành một công cụ đắc lực trong việc tối ưu hóa phản hồi của AI. Bằng cách lưu trữ và truy xuất thông tin theo ngữ nghĩa, nó giúp giảm chi phí và tăng hiệu quả. Bài viết này sẽ khám phá các khía cạnh khác nhau của Semantic Cache và so sánh với các hình thức cache truyền thống.
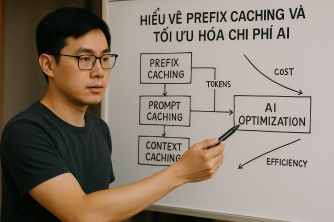
Trong bối cảnh AI ngày càng trở thành một phần không thể thiếu, việc tối ưu hóa chi phí trở nên quan trọng hơn bao giờ hết. Bài viết này sẽ đi sâu vào các khái niệm như Prefix Caching, Prompt Caching, và Context Caching, để hiểu cách chúng có thể giảm thiểu chi phí và tăng hiệu năng xử lý trong các hệ thống AI.
Trong thế giới trí tuệ nhân tạo ngày nay, tối ưu hóa hiệu suất là vô cùng quan trọng. Bài viết này sẽ khám phá cách Continuous Batching có thể cải thiện Throughput khi phục vụ LLM, đồng thời phân tích vai trò của GPU utilization và các yếu tố khác như Dynamic Batching và KV Cache.
Tokens Per Second (TPS) là một thước đo quan trọng để đánh giá hiệu suất của mô hình AI trong việc xử lý dữ liệu. Bài viết này khám phá cách TPS được đo lường, những yếu tố ảnh hưởng, và sự khác biệt giữa TPS và throughput. Qua đó, chúng ta cũng tìm hiểu tầm quan trọng của TPS đối với trải nghiệm người dùng.
Inter-Token Latency (ITL) đóng vai trò quan trọng trong việc tối ưu hóa trải nghiệm người dùng khi tương tác với hệ thống AI. Trong bối cảnh những công nghệ như LLM, TPOT trở nên phổ biến, hiểu rõ và quản lý ITL hiệu quả là cần thiết để cải thiện hiệu suất phản hồi, giảm thiểu thời gian chờ đợi và nâng cao chất lượng dịch vụ.
Thời gian để nhận được từ đầu tiên (TTFT) là một yếu tố quan trọng trong hiệu suất của các mô hình trí tuệ nhân tạo (AI). Trong bài viết này, chúng ta sẽ khám phá TTFT là gì, tầm quan trọng của nó, các yếu tố ảnh hưởng, và cách cải thiện TTFT trong các hệ thống AI khi triển khai vào sản xuất.
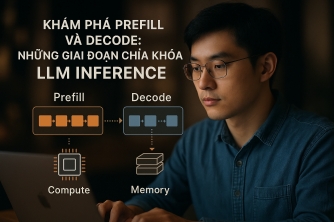
Trong thế giới của các mô hình ngôn ngữ lớn (LLM), hiểu rõ các giai đoạn Prefill và Decode là nền tảng để tối ưu hóa quá trình suy luận. Bài viết này sẽ đi sâu vào Prefill đối với Compute, Decode đối với Memory, và làm thế nào để tối ưu hóa hai giai đoạn này nhằm cải thiện hiệu năng LLM Inference.
Disaggregated Inference đang thay đổi cách chúng ta tiếp cận inference cho LLM quy mô lớn, hướng đến kiến trúc linh hoạt và tối ưu. Trong bài viết này, chúng ta sẽ khám phá sự cần thiết của Disaggregated Inference, sự khác biệt giữa Prefill và Decode, và ảnh hưởng của nó đến latency, throughput, cùng những thách thức sản xuất mà nó đặt ra.